一块四平方米地里,怎样把植物和土壤放进同一份记录
每块样方先数所有Mimosa pigra个体。土壤部分没有只在中心挖一铲。研究者在一块样方内随机选5个取样站,每站以三角形布置取3根土芯,再把同一块样方的土芯混合成一份样品。取土深度为0至30厘米,样品装入密封塑料袋保存水分,随后分析有机质、pH、有效磷、交换性钾和电导率。
论文也记录了植株平均茎径、土壤质地和土壤结构。质地与结构依照USDA土壤方法和《Soil Survey Manual》的田野规程分类;磷用Bray II提取法,交换性钾经乙酸铵提取后用火焰光度法和原子吸收光谱法测量,pH则用土水比1比1的悬液和玻璃电极测定。每块样方的植株数,都有一份与它对应的土壤记录。
表2把50块样方的描述统计放在一起。平均土壤pH为6.61,平均钾浓度为46.21 ppm;每平方米巨型含羞草密度平均为12.49株,记录范围从1.5到35.5株。密度范围拉得很开,因此同一地区的地块并没有长成一样。论文把这种离散且差异大的计数资料当作模型选择的一部分,而没有只报一个平均密度就结束。
50个样方不是50次同样的答案
如果每块地的个体数围绕均值小幅上下浮动,Poisson模型常可用来处理计数。这里的密度变化更大,作者同时拟合Poisson和负二项回归。两者都用对数连接函数,把每块样方的个体数同土壤和植株变量联系起来;负二项模型另有离散参数,可处理观测值的变异大于Poisson假定的情况。
两种模型都把预期个体数放在对数尺度上处理,协变量的作用因此对应预期计数的乘法变化,而不是在每平方米密度上直接加减一个固定数,也使模型的预期值保持为非负数,符合样方中个体数这一计数资料的形式和范围。论文用的是观察到的样方资料:模型可以说明变量与密度怎样一起变化,不能把它改写成施加某种土壤条件后的对照试验结果。
研究采用贝叶斯广义线性模型,以Hamiltonian Monte Carlo在R的brms和Stan环境中拟合。每个模型跑4条链,每条4000次迭代,其中1000次为warm-up。作者用R-hat和有效样本量查看收敛,也用后验预测检验和LOOIC比较模型。方法细节在这里值得保留,因为论文的结论不是从某一块地直接看出来的,而是从50块地的计数与协变量一起估计出来的。
图2和图3不是植物照片。它们分别画出Poisson和负二项模型的后验预测检查,包括观测与预测分布的密度叠图,以及不同计数值频数的柱图。作者写道,两个模型都能抓到观测资料的大致形状,Poisson在较高计数范围低估了变异,负二项模型对整段分布和尾部的贴合更近。图4至图6继续用预测区间展示负二项模型的观测值、预测中位数和95%区间,提醒读者模型给的是带不确定性的估计。
表5和表6给出的模型比较差距并不大:负二项模型的LOOIC为311.0,Poisson为311.9;对应的Bayesian R²则为0.596和0.615。作者仍把负二项模型选作后续解释的模型,理由是它的LOOIC略低,并能显式处理过度离散。两项指标没有指向同一个“绝对赢家”,正是这张表该被完整阅读的原因。
哪些变量在模型里留下了清楚的信号
模型的候选变量包括pH、有机质、磷、钾、电导率、平均茎径、土壤质地和土壤结构。分类变量并不是抽象的“土壤好或坏”。作者把Clay设为质地的参考类别,把Granular设为结构的参考类别,再用其他类别的系数同它们比较。最终的负二项模型方程把预期密度写成钾、茎径、若干质地类别和若干结构类别的组合。
表3的Poisson结果中,钾、茎径,以及Clay Loam、Sandy Clay、Sandy Clay Loam、Sandy Loam和Silty Clay等质地类别的95%可信区间不跨零;Subangular结构与密度呈负向关系。表4的负二项结果有相近的方向,但可信区间较宽。论文在讨论中又把表7的简化系数表单独说明:土壤质地与茎径有实质作用,而钾浓度的效应显得较弱;Loam、Silty Clay Loam和Angular结构的95%可信区间跨零,因此没有写入那段简化说明。
表3、表4和表7说的是不同层次。Clay和Granular是分类变量的参照类别,系数只表示其他类别相对于它们的估计。钾被纳入模型,两个表给出统计信号,表7文字则说它的效应显得较弱。把这些结果放回50块样方的记录里读,才不会把单个系数当成任何地点都适用的密度规则。
土样与采样区的背景
样方的土样是合并样,不是15根土芯各自对应一个植株数。一个样方里五个取样站、每站三根土芯,最后混为一份理化分析样品;对应的植物数则是整块4平方米地内的所有个体。这样做以后,表2中的pH、钾和其他土壤数字应理解为地块层面的记录。它们可与同一地块的密度比较,却不能拿来描述某一株巨型含羞草根边的即时土壤条件。
表2还列入有机质、磷、容重、茎径、株高和生物量。论文报告磷在各采样点较低,生物量的变异也很大。表3和表4随后把这些候选变量放进两种计数模型,读者需要把描述统计与模型估计分开看。
地点本身也给数字提供了背景。论文把玛哈沙拉堪描述为热带季风气候,年平均气温约27至28摄氏度,年降雨量约1200至1400毫米;降水集中在5月至10月,11月至4月是明显干季。当地土地利用以水稻为主,也有甘蔗、木薯、湿地和受扰动的农业边缘。作者用这些资料说明采样区域,并没有在50个样方内逐项测量每一次降雨、淹水时长或每一块农地的耕作历史。图1能显示样方与水文和土地利用的空间关系,不能替代这些缺失变量的现场量测。
没有被量到的部分,决定了这篇论文该怎样用
作者在方法部分直接列出没有进入模型的变量。土壤水分、土地利用强度、邻近农田或道路等人为干扰,因为无法在所有样方获得一致且可比的量测而未纳入;论文也说洪泛平原中的水文和干扰会影响物种建立。讨论部分还指出,50块样方来自单一府份和有限时段,季节性降雨与洪水变化没有被显式纳入。
这项研究比较的问题是:在这些地块里,若把植株计数和一组土壤、形态变量放在一起,哪种计数模型较适合,哪些变量值得继续跟踪。它没有测量全国蔓延速度,也没有比较除草、焚烧或生物防治的效果。若以后把同样的方法扩展到别处,论文自己提出的方向是加入跨季节样方、其他地区,以及水分、洪水频率、土地利用和人为干扰等资料。
还有一个容易混淆的层次是密度与阶段。论文把平均茎径作为协变量,并在讨论中把茎径和密度的负向关系联系到种内竞争与自疏过程。这个解释提供的是一种查看样方的线索:较密的地块与单株大小可能一起变化。它不是逐株追踪得出的生长史,也没有把每块地按入侵年份排序,更没有提供同一地块跨季节反复量测的序列或连续影像资料,因此无法还原一块地随季节变化的密度轨迹。读者若想用茎径观察当地植株,仍需把它看成论文模型中的一项记录,而不是判定植株年龄的尺子。
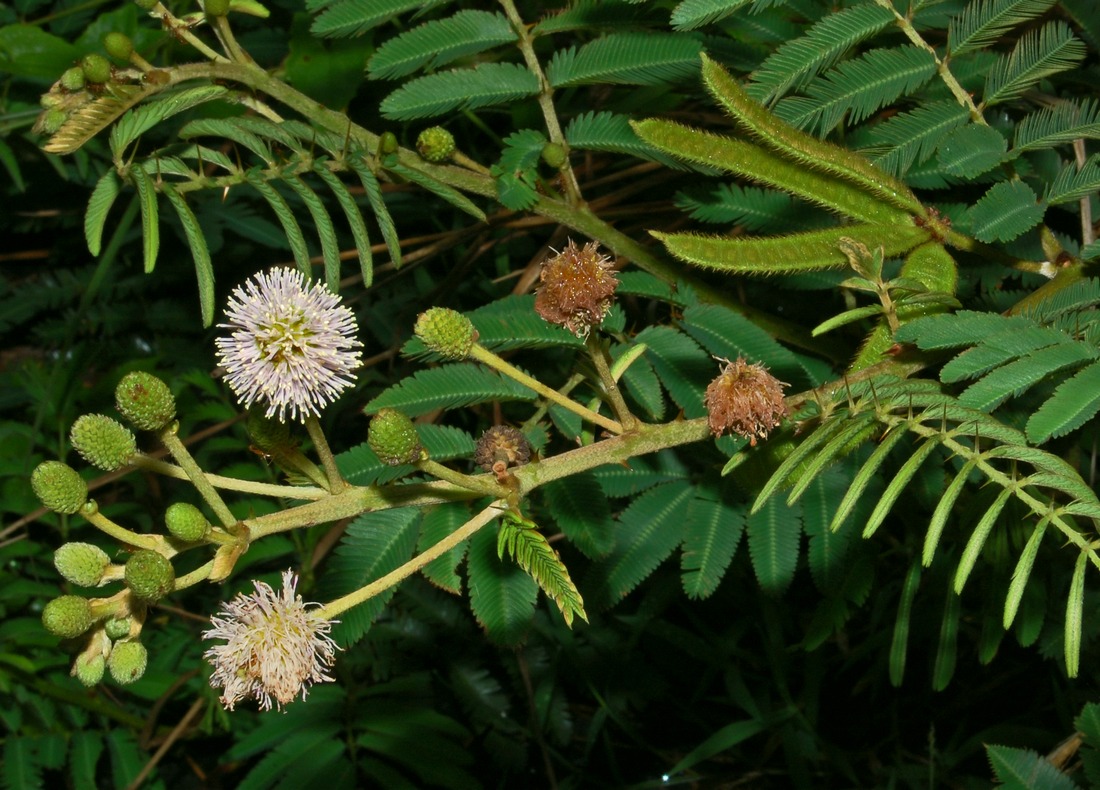
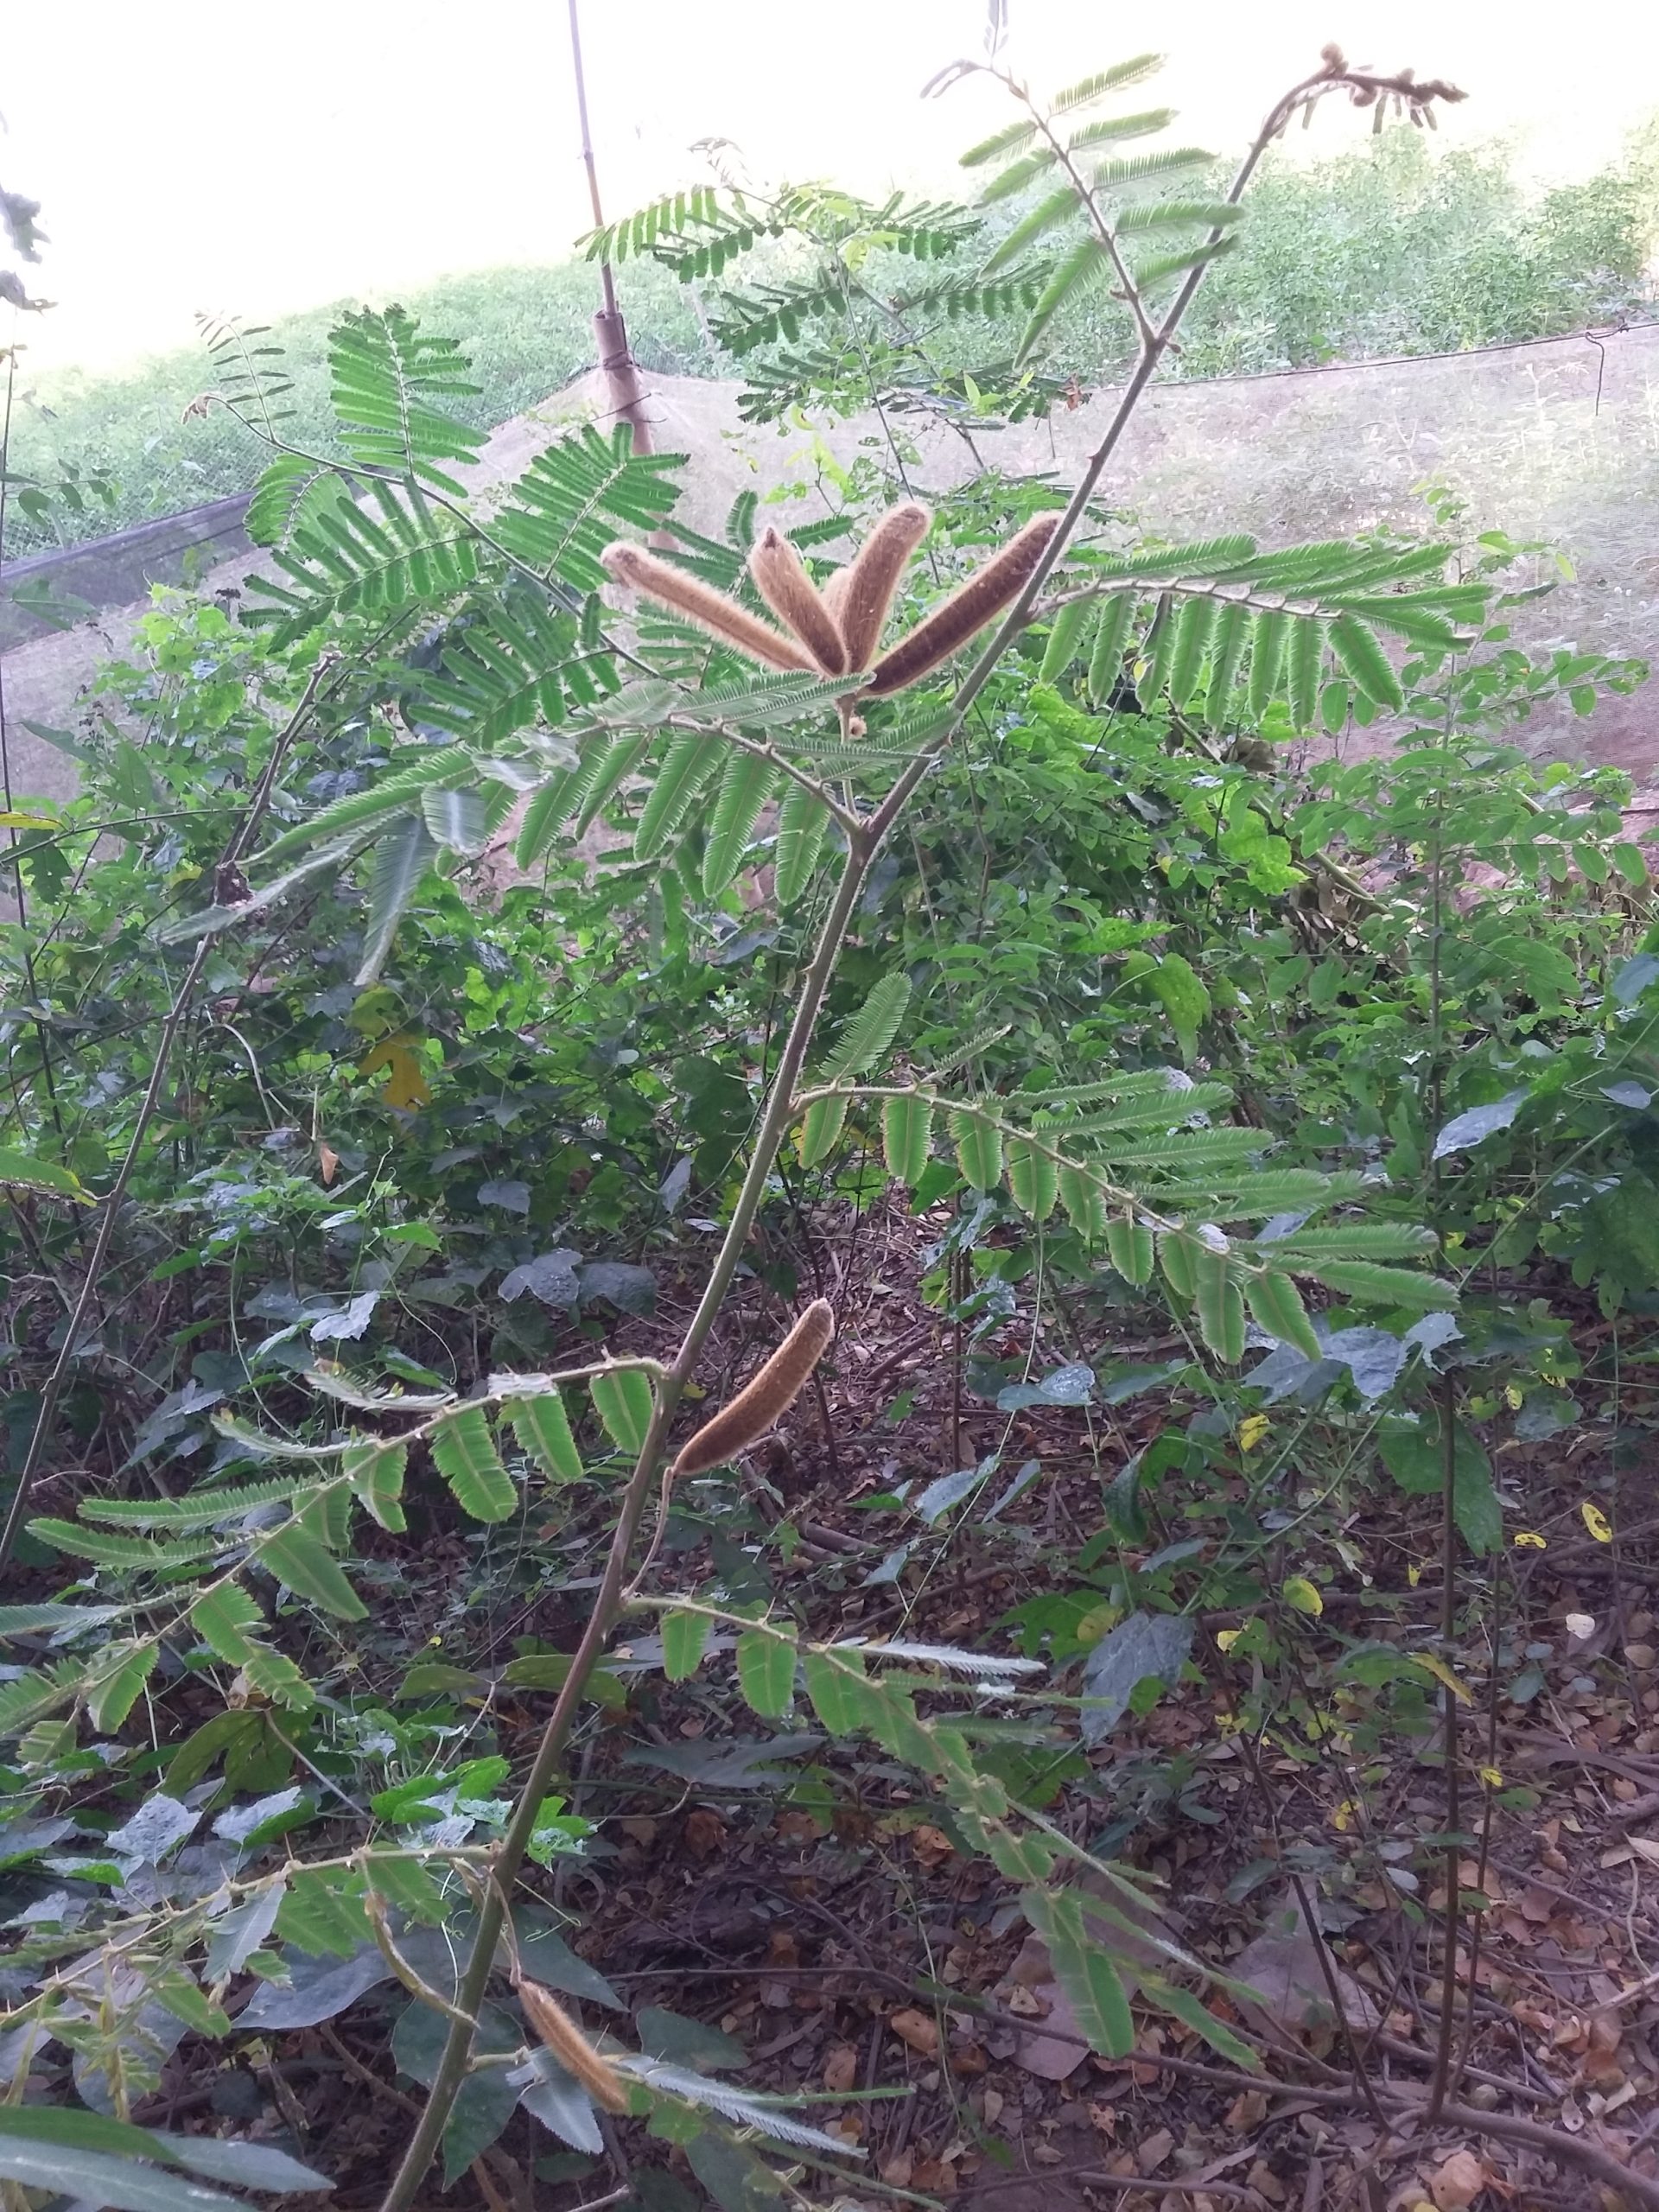
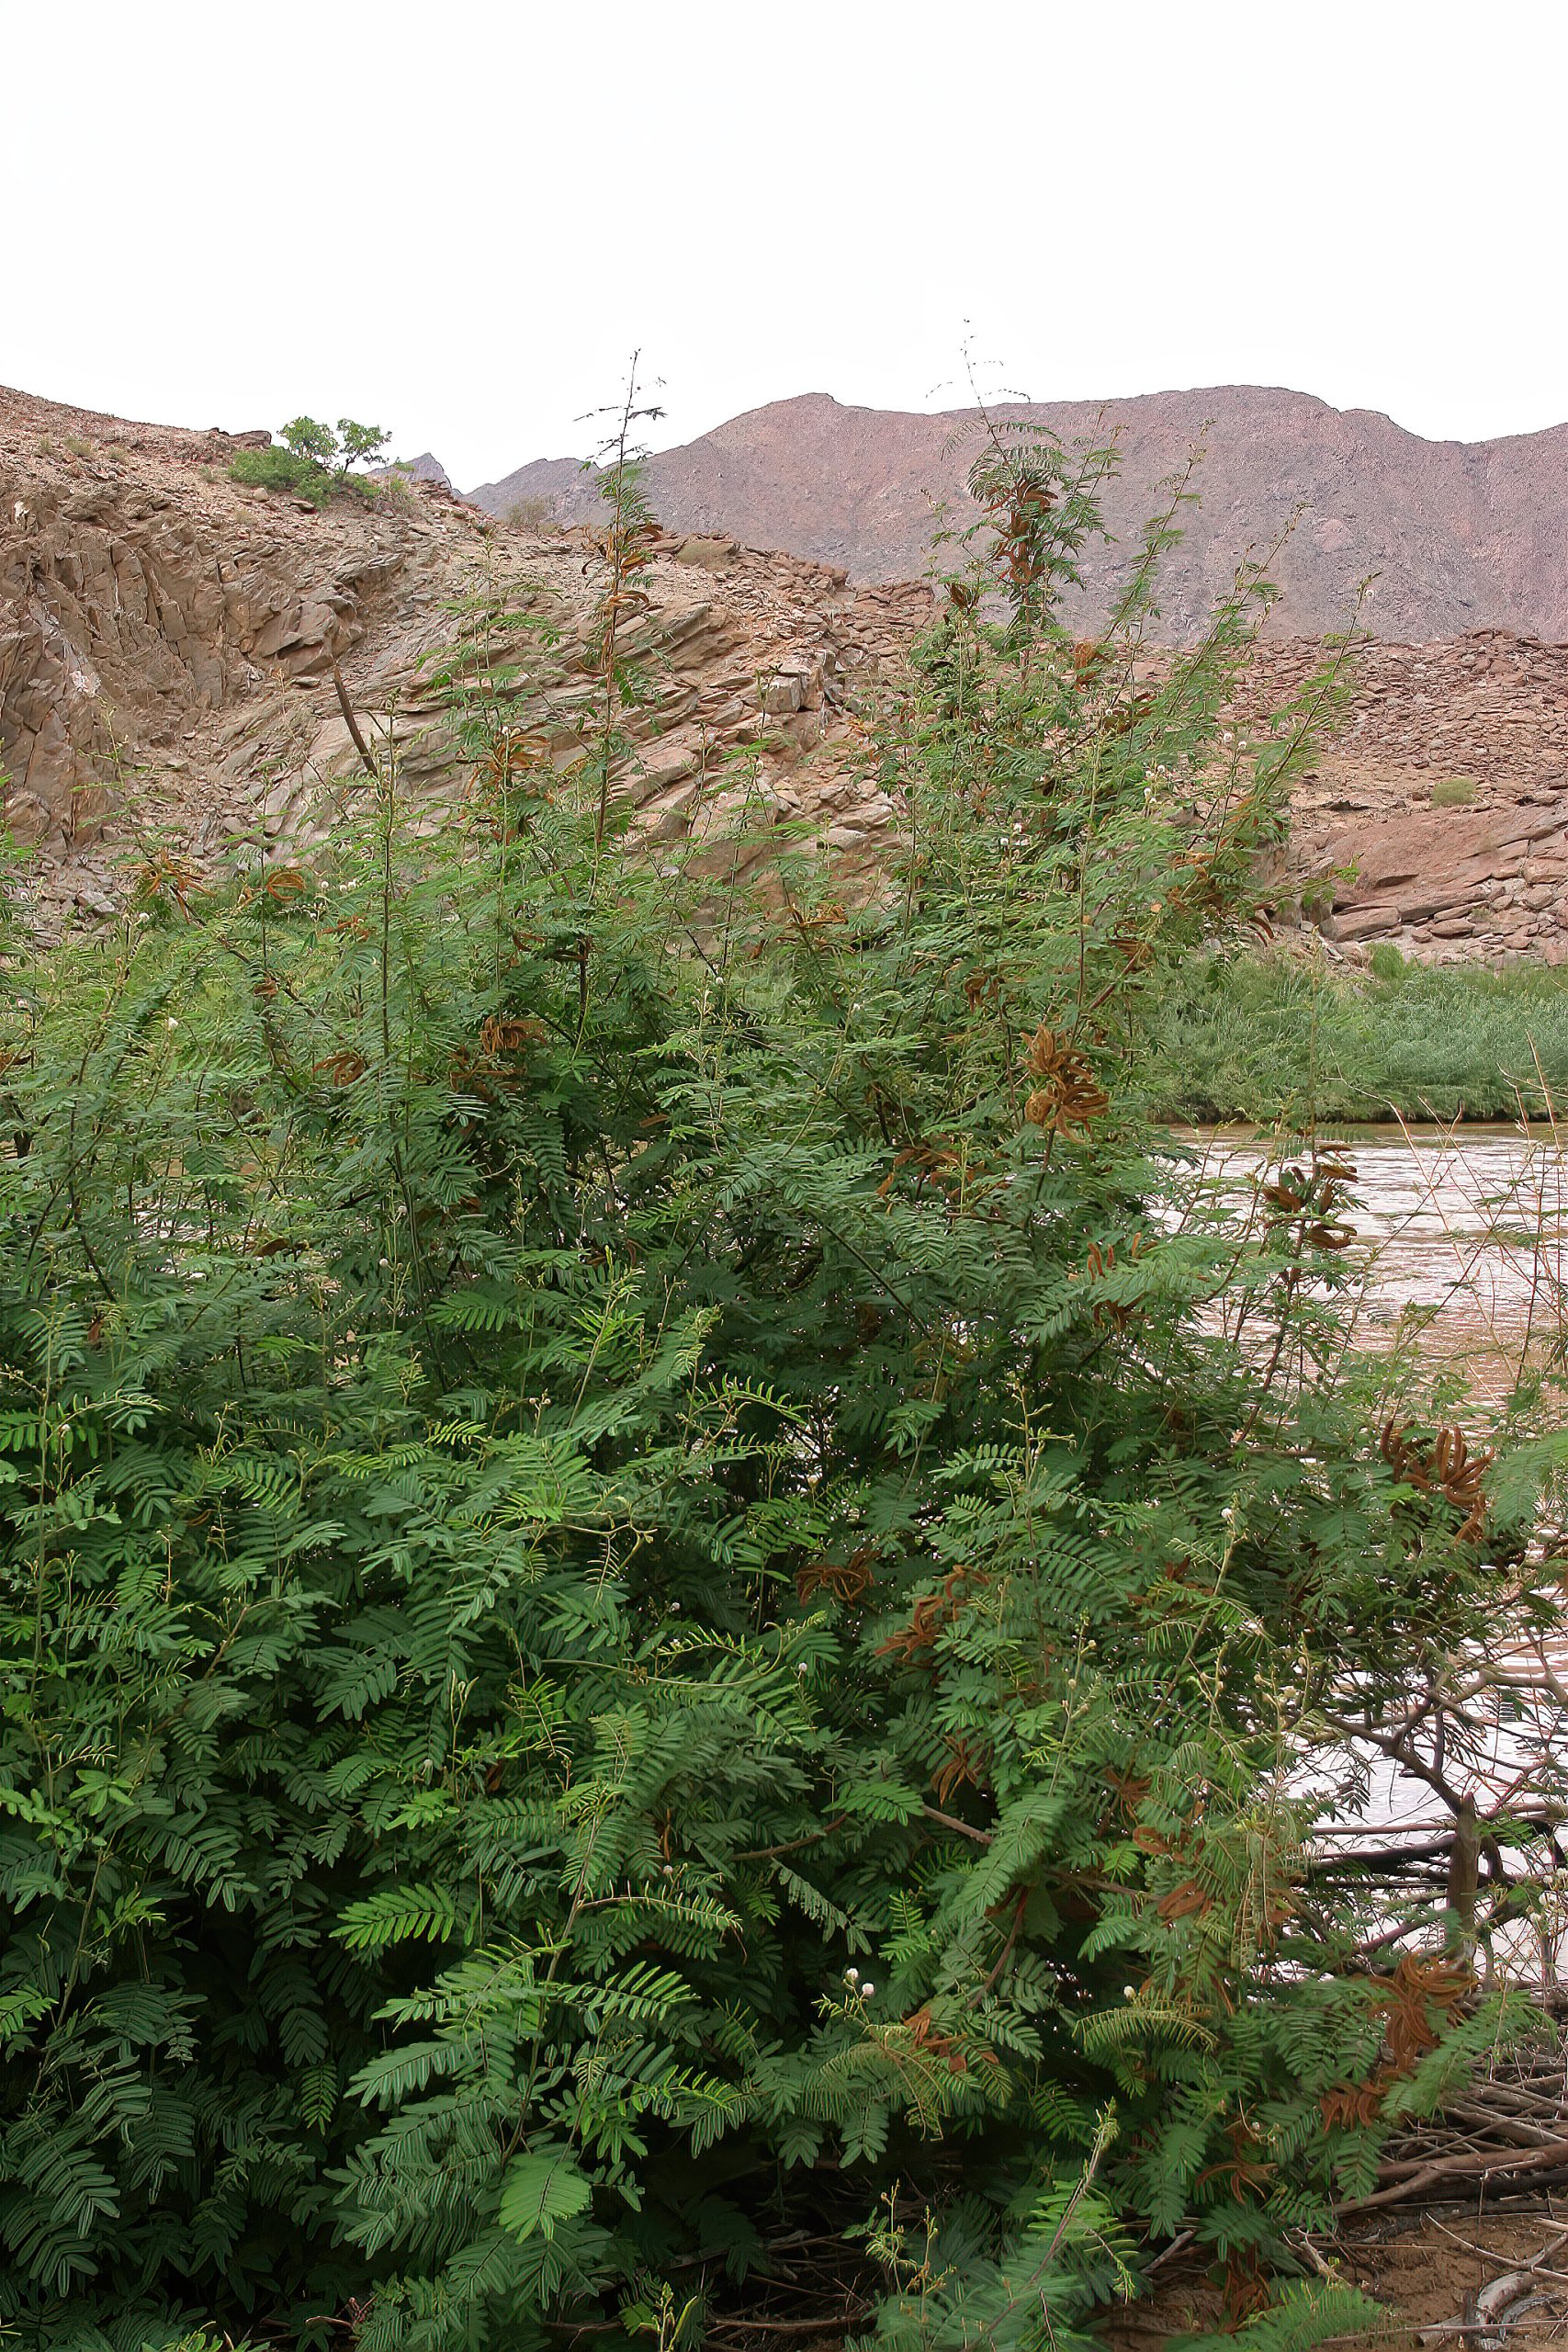
三张图片只帮助辨认植株的枝叶、花果和河岸生长形态。首图来自印度尼西亚西爪哇茂物;第二张Commons记录未提供地理位置;第三张来自纳米比亚Kunene River河岸。它们均非玛哈沙拉堪的50块样方,也不代替论文的图1至图6。
另一处现场:澳大利亚的管理影像
澳大利亚Territory NRM发布的这段影像拍于达尔文以南的Finniss River流域,标题和片头使用英语文字,播放器没有可用字幕。约1分钟起,可见工作人员站在林间植株旁。视频展示另一地区的巨型含羞草管理场景,与玛哈沙拉堪的土壤和密度调查分开观看。